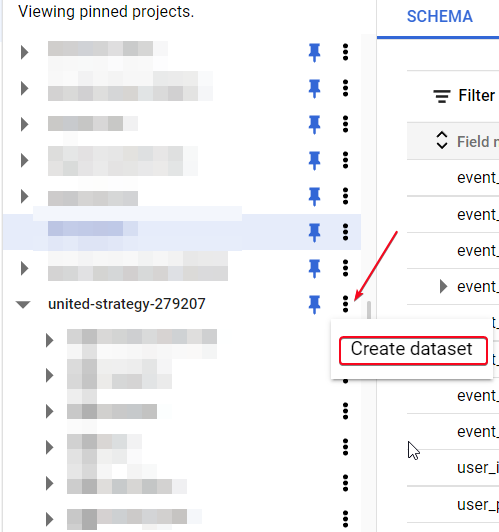
В данной статье будут рассмотрены популярные SQL запросы Google BigQuery Язык Data Manipulation Language представляет из себя набор следующих команд: SELECT – выборка данных INSERT – вставка новых данных UPDATE – обновление данных DELETE – удаление данных MERGE – слияние данных Рассмотрим их далее, но начнем мы с создания таблицы через SQL запрос. CREATE TABLE Подробнее о создании таблиц читайте в нашей статье. Чтобы приступить к работе нужно создать базу или загрузить ее. Напишем небольшой SQL запрос, который создаст таблицу:
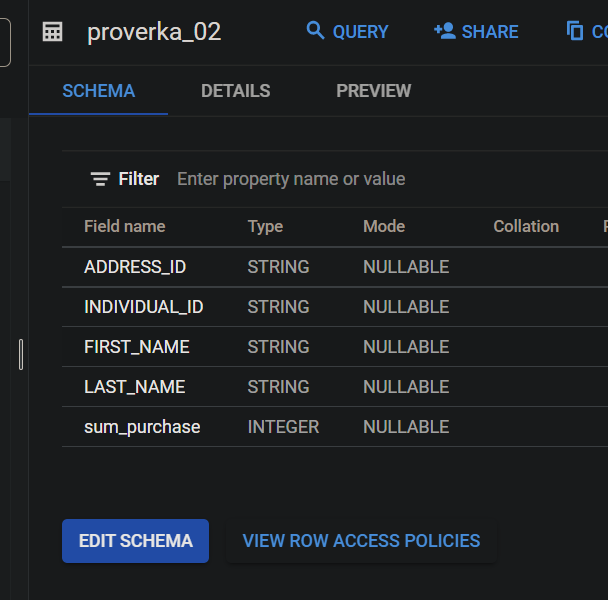
Создаем таблицу (если такой нету) с названием "имя проекта.имя дата сета.название таблицы". Дальше столбцы нашей будущей таблицы с указанием формата поля. Пример:
CREATE TABLE IF NOT EXISTS `project.dataset.table_name`
(
  someName STRING,
  dateTime TIMESTAMP NOT NULL, -- REQUIRED or non-null column
  index INT64, -- INT64 for INTEGER column
  longitude FLOAT64 -- FLOAT64 for FLOAT column
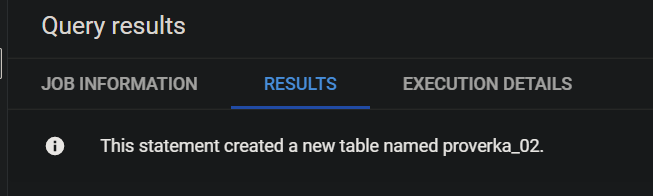
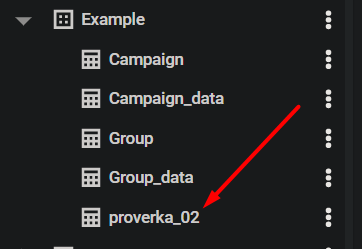
);CREATE TABLE IF NOT EXISTS `united-strategy-279207.Example.proverka_02`
(
ADDRESS_ID STRING,
INDIVIDUAL_ID STRING,
FIRST_NAME STRING,
LAST_NAME STRING,
sum_purchase INT64
);
INSERT в Google Big Query SQL Команда INSERT INTO в SQL отвечает за добавление данных в таблицу:INSERT INTO `united-strategy-279207.Example.proverka_02`
(ADDRESS_ID,INDIVIDUAL_ID,FIRST_NAME,LAST_NAME,sum_purchase)
VALUES
('1','1','Petya','Sssss',1000),
('2','2','Ivan','Qqqqqq',2000),
('3','3','Pasha','Rrrrrr',5000),
('4','4','Dima','Vvvvvv',777)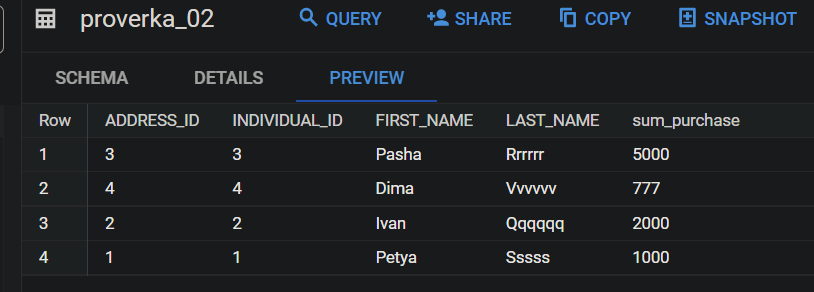
При добавлении данных в каждый столбец таблицы не требуется указывать названия столбцов.
INSERT INTO `united-strategy-279207.Example.proverka_02`
   VALUES
   ('5','5','Sliva','Ddddd',300),
   ('6','6','Darya','OOoooo',5000)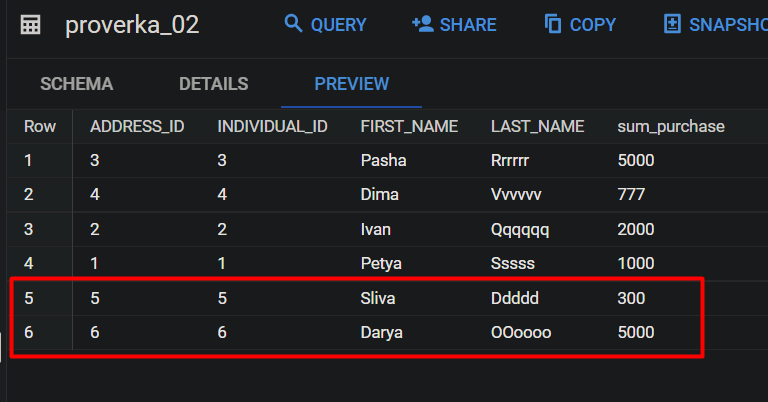
Старый вид таблицы:
UPDATE в Google Big Query SQL SQL-команда для обновления данных таблицы UPDATE SET:UPDATE `united-strategy-279207.Example.proverka_02`
SET ADDRESS_ID = 'bbbbbbb', INDIVIDUAL_ID = '222222', FIRST_NAME = 'Kapustka', LAST_NAME = 'jirniy', sum_purchase = 202002
WHERE ADDRESS_ID = 'f43j231';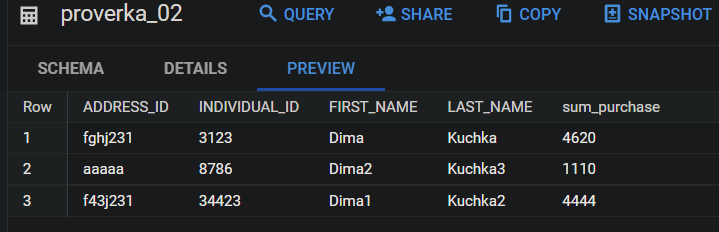
В SQL запросе изменяем строку с ADDRESS_ID которая имеет значение 'f43j231' на:
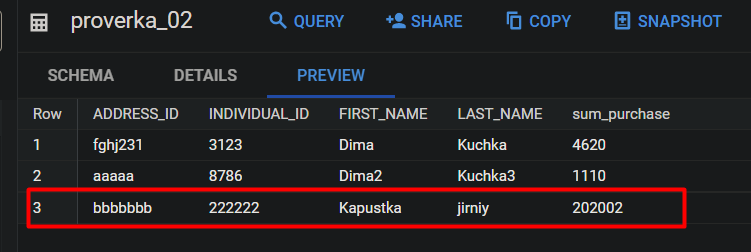
DELETE в Google Big Query SQL SQL-команда DELETE FROM table_name используется для удаления данных из таблицы.DELETE FROM `united-strategy-279207.Example.proverka_02`
WHERE ADDRESS_ID = 'fghj231';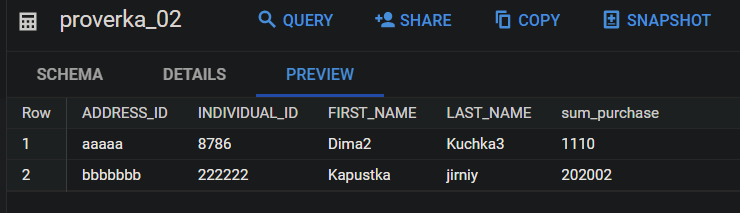
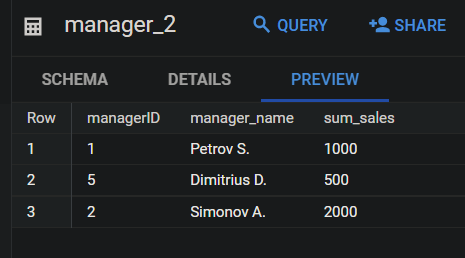
MERGE в Google Big Query SQL С помощью MERGE можно осуществить слияние двух таблиц, т.е. синхронизировать их. Для теста SQL запроса создаём таблицу:
И еще одну:
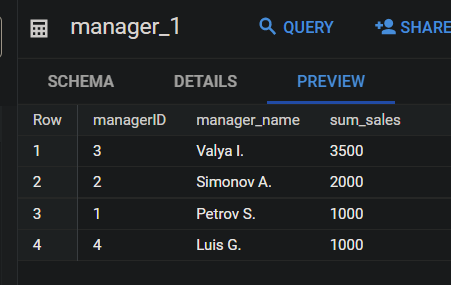
Что мы хотим сделать:
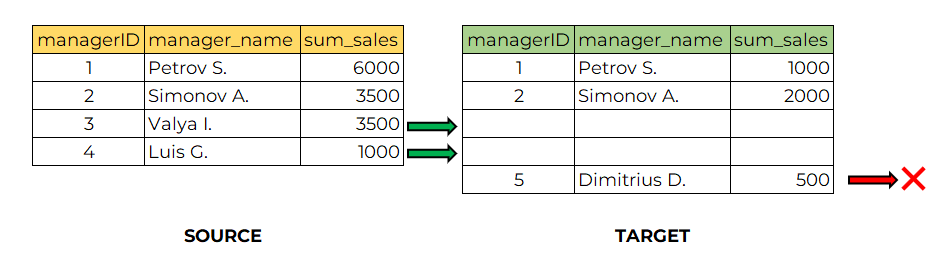
Из таблицы SOURCE (manager_1) добавить 3 и 4 менеджера в таблицу TARGET (manager_2), обновить 1 и 2 менеджера (их продажи) и удалить 5 менеджера.
MERGE `united-strategy-279207.Example.manager_2` as target
USING `united-strategy-279207.Example.manager_1` as source
ON target.managerID = source.managerID
   WHEN MATCHED
       THEN UPDATE SET managerID = source.managerID
   WHEN NOT MATCHED
       THEN INSERT
          VALUES ( source.managerID, source.manager_name, source.sum_sales)
   WHEN NOT MATCHED BY SOURCE
       THEN
           DELETE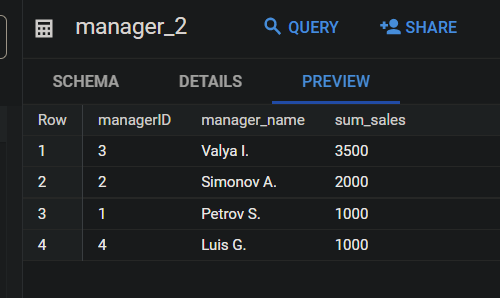
Target table — целевая таблица, именно в ней данные будут добавлены, изменены или удалены в результате запуска SQL запроса. Source table — исходная таблица или таблица-источник данных, с которой будет сравниваться целевая таблица, это может быть любой набор данных.
Оператор USING похож на FROM из оператора SELECT, тут можно указать таблицу, подзапрос, табличное выражение или функцию, возвращающую таблицу. Далее ON — условие соединения двух таблиц (а точнее, наборов данных), такое же как ON в JOIN. When Matched — описывает действие, которое срабатывает для строк, которые нашлись и в Source, и в Target по условию, которое описано в ON.
В этой части чаще всего встречается оператор UPDATE, хотя возможно использование оператора DELETE. When Not Matched — описывает действие для строк, которые есть в таблице Source, но отсутствуют в таблице Target; далее используется оператор INSERT, и указанные строки добавляются в таблицу Target.
When Not Matched by source — описывает действие для строк, которые отсутствуют в таблице Source, но найдены в таблице Target, чаще всего встречается оператор DELETE, чтобы удалить строки и привести 2 набора в соответствие, но возможно использование оператора Update.
Использование SELECT в Google Big Query SQL
SELECT – оператор выборки данных. Любой Big Query SQL запрос состоит из: SELECT (обязательно): определяет столбцы, которые будут включены в запрос. FROM (обязательно): таблица, содержащая столбцы, откуда мы хотим взять данные, которые мы указали в операторе SELECT WHERE: условие фильтрации записей. Какие именно данные мы хотим вывести, например, за определенный промежуток времени ORDER BY: используется для сортировки результата в порядке возрастания или убывания (desc & ask) GROUP BY: как агрегировать данные в результирующем наборе. Как объединить данные, по каким столбцам, например, город или категория устройства (mob) В словах это: SELECT (ВЫБЕРИ) - список_столбцов или * (все столбцы, которые есть в таблице) FROM (ОТКУДА) - путь к таблице, из которой мы забираем эти данные WHERE (ГДЕ) (не обязательно) - конкретизация того, что мы хотим получить в результате ORDER BY ( ОТСОРТИРОВАТЬ ПО) (не обязательно) - по какому принципу отсортировать данные, в порядке убывания или возрастания.
SELECT + FROM Например, возьмем нашу созданную ранее таблицу с манагерами:select * from `united-strategy-279207.Example.manager_2`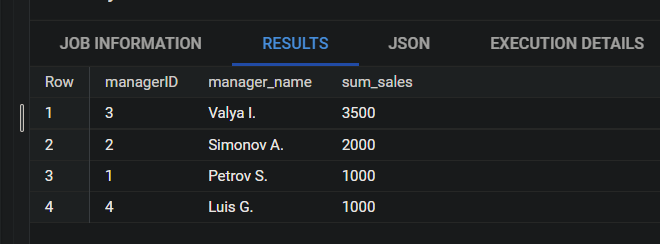
ORDER BY в Google BigQuery SQL Отсортируем по возрастанию ИД менеджеров asc или по убыванию desc
select * from `united-strategy-279207.Example.manager_2`
  order by managerID asc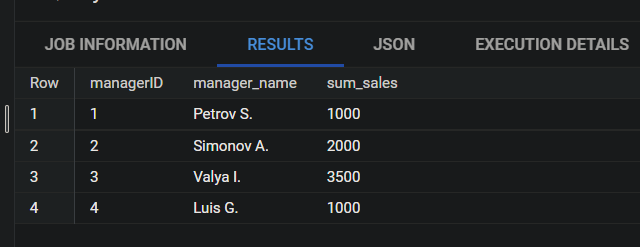
WHERE в Google BigQuery SQL Можно использовать ключевое слово WHERE в SELECT для указания условий в Big Query SQL запросе. Пример: С помощью оператора WHERE можем указать каких менеджеров мы хотим вывести в результате, например, с продажами меньше 2000
select * from `united-strategy-279207.Example.manager_2`
  where sum_sales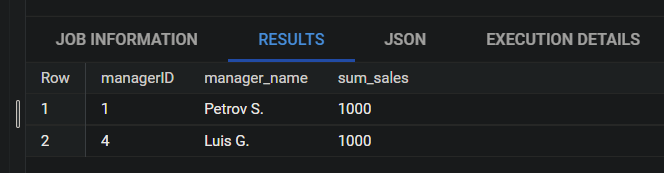
SELECT DISTINCT в Google BigQuery SQL В столбцах таблицы могут содержаться повторяющиеся данные, для получения только неповторяющихся данных используем SELECT DISTINCT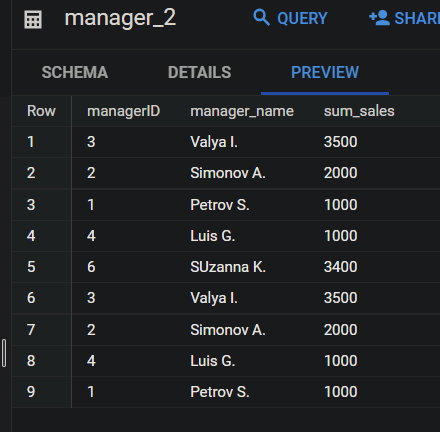
Например, у нас есть повторяющиеся записи, которые мы не увидим в результате Google Big Query SQL запроса
select distinct * from `united-strategy-279207.Example.manager_2`
  order by managerID asc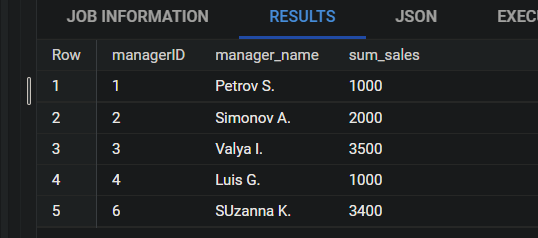
GROUP BY в Google BigQuery SQL Оператор GROUP BY часто используется с агрегатными функциями, такими как COUNT, MAX, MIN, SUM и AVG, для группировки выходных значений.
Посчитаем сумму всех продаж каждого менеджера
select sum (sum_sales) as count_sales, manager_name
   from `united-strategy-279207.Example.manager_2`
   group by manager_name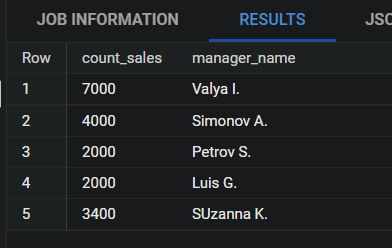
HAVING в Google BigQuery SQL Ключевое слово HAVING было добавлено в Google Big Query SQL по той причине, что WHERE не может использоваться для работы с агрегатными функциями.
Хотим отфильтровать менеджеров по сумму продаж, которая превышает 2000
select sum (sum_sales) as count_sales, manager_name
from `united-strategy-279207.Example.manager_2`
  group by manager_name
  having sum (sum_sales) > 2000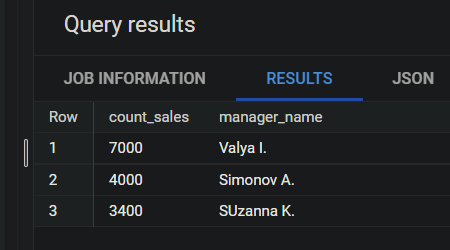
BETWEEN в Google BigQuery SQL BETWEEN используется для выбора значений из определённого промежутка. Могут быть использованы числовые и текстовые значения, а также даты. Таблица с полными данными.
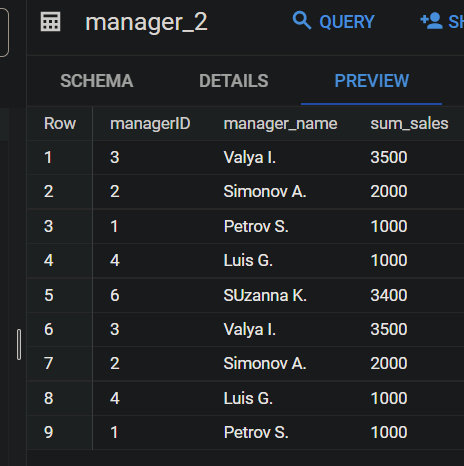
Хотим увидеть менеджеров с суммой продаж от 1000 до 2000
select manager_name, sum_sales  from `united-strategy-279207.Example.manager_2`
 where sum_sales between 1000 and 3000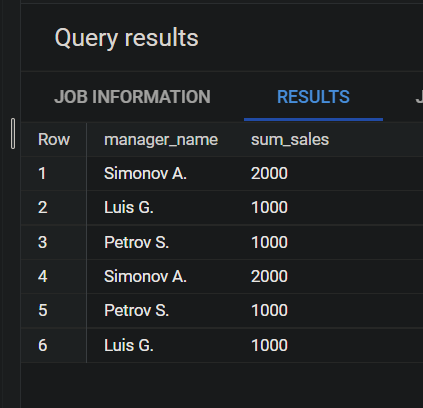
LIKE в Google BigQuery SQL Оператор LIKE используется в WHERE, чтобы задать шаблон поиска похожего значения. Есть два оператора, которые используются в LIKE: «%» - ни одного, один или несколько символов «_» - один символ Пример: Выведем имена менеджеров, у которых есть буква «А»
select manager_name, sum_sales  from `united-strategy-279207.Example.manager_2`
 where manager_name like '%A%'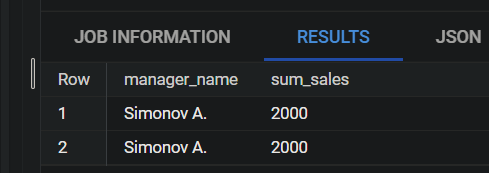
Выведем имена менеджеров, у которых есть маленькая буква «а»
select manager_name, sum_sales  from `united-strategy-279207.Example.manager_2`
 where manager_name like '%a%'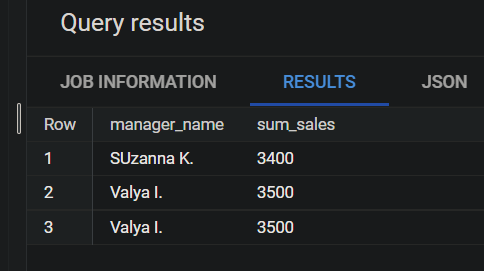
Выведем тех, у кого в имени четыре буквы и две буквы в инициале
select manager_name, sum_sales  from `united-strategy-279207.Example.manager_2`
 where manager_name like '____ __'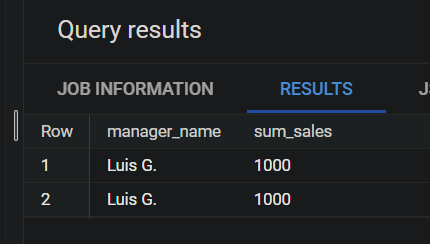
IN С помощью IN можно указать несколько значений для оператора WHERE: Хотим узнать имена менеджеров, у которых сумма продаж 1000 и 2000
select manager_name, sum_sales  from `united-strategy-279207.Example.manager_2`
 where sum_sales in (1000,2000)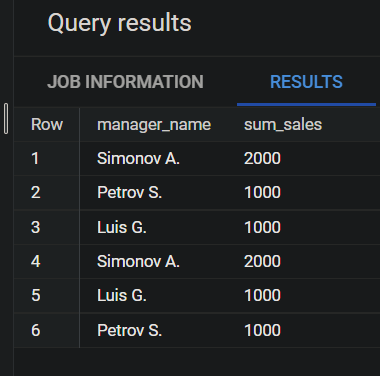
Агрегатные функции в Google Big Query SQL Такие функции используются для получения совокупного результата, относящегося к рассматриваемым данным:
COUNT (название_столбца) — возвращает количество строк;
SUM (название_столбца) — возвращает сумму значений в данном столбце;
AVG (название_столбца) — возвращает среднее значение данного столбца;
MIN (название_столбца) — возвращает наименьшее значение данного столбца;
MAX (название_столбца) — возвращает наибольшее значение данного столбца.
COUNT ( DISTINCT (название_столбца)) - возвращает количество уникальных строк в столбце название_столбца
select count(sum_sales) as count_sales,
        sum(sum_sales) as sum_sum_sales,
        avg(sum_sales) as avg_sales,
        min (sum_sales) as min_sales,
        max (sum_sales) as max_sales,
        count (distinct sum_sales) as distinct_count_sum_sales
  from `united-strategy-279207.Example.manager_2`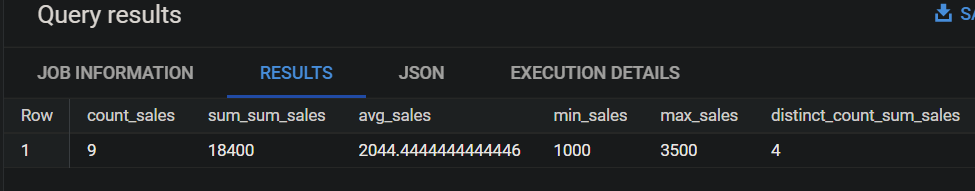
Подзапросы (subqueries) в Google Big Query SQL Вложенные запросы (подзапросы) — это BigQuery SQL-запросы, которые включают выражения SELECT, FROM и WHERE, вложенные в другой запрос. Подзапрос может использоваться: В инструкции SELECT; В инструкции FROM; В условии WHERE. Внутренний SQL запрос выполняется перед общим запросом, чтобы результаты его работы могли быть переданы внешнему. Основной запрос использует результат выполнения подзапроса. Подзапросы не могут обрабатывать свои результаты Подзапрос можно использовать в инструкциях SELECT для выполнения следующих задач: Сравнения выражения с результатом запроса; Определения того, включено ли выражение в результаты SQL запроса; Синтаксис: SELECT необходимые столбцы FROM путь до таблицы WHERE условие выборки данных ( SELECT необходимые столбцы FROM путь до таблицы);
Пример: Полная таблица
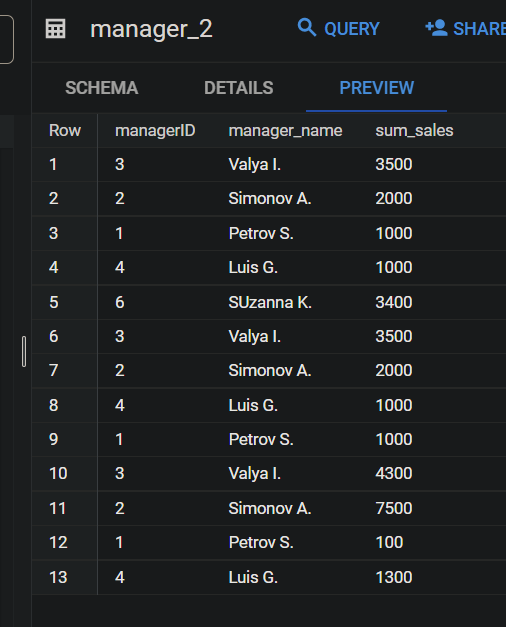
Выбрать имена менеджеров с продажами выше средней. Разобьем на подзадачи. 1. Сначала нам нужно найти среднее из всех продаж:
select avg(sum_sales) as avg_sales from `united-strategy-279207.Example.manager_2`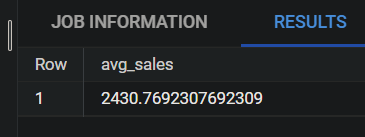
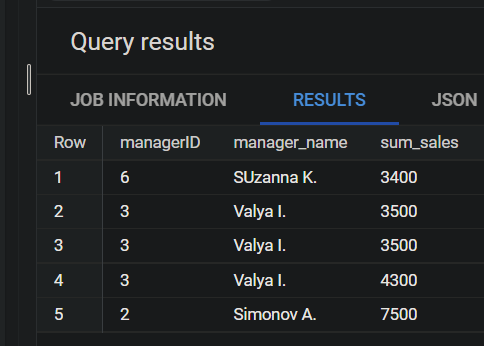
2. Теперь просто подставить в основной запрос, в котором мы выбираем всех менеджеров, у которых сумма продаж больше средней
select * from `united-strategy-279207.Example.manager_2`
  where sum_sales >
  (select avg(sum_sales) from `united-strategy-279207.Example.manager_2`
  )
JOIN в Google BigQuery SQL BigQuery JOIN используется для связи двух или более таблиц с помощью общих атрибутов внутри них. Синтаксис: SELECT `название столбца`… FROM `путь до таблицы 1 (название таблицы) ` JOIN `путь до таблицы 2` ON 'путь до таблицы 1.название столбца' = 'путь до таблицы 2.название столбца' CROSS JOIN – это JOIN без указания соединения, то есть все на все умноженное и выведено как попало (крест на крест). SELECT * FROM users CROSS JOIN city тоже самое что и просто: SELECT * FROM users JOIN city INNER JOIN (внутреннее объединение) – это JOIN с указанием что конкретно мы хотим вывести в результате. То есть условие объединения данных из разных таблиц.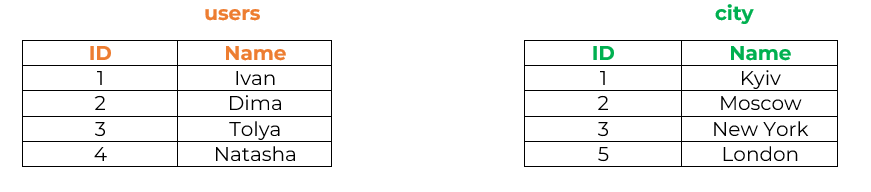
SELECT user.name, city.name FROM users INNER JOIN city ON users.id = city.id тоже самое что и просто: SELECT * FROM users JOIN city ON users.id = city.id Результатом запроса будет таблица: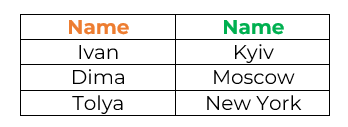
Так как в таблице пользователей есть ID «4», но нет в таблице городов, а в таблице городов есть ID «5», но нету в таблице пользователей, то в объединенных данных их не будет. LEFT JOIN в Google BigQuery SQL (внешнее объединениe) – объединение таблицы которая стоит слева от джоина. На примере будет понятнее. Есть две таблицы:
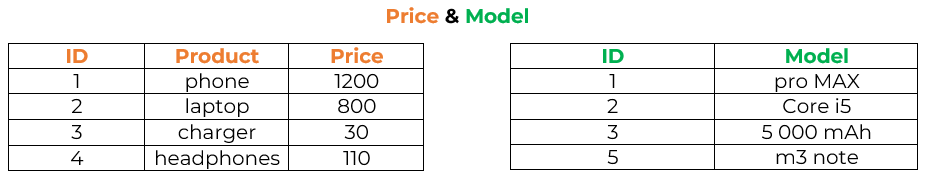
Результатом такого запроса будет таблица:
SELECT p.product, p.price, m.model FROM price AS p
LEFT JOIN model AS m ON p.id = m.id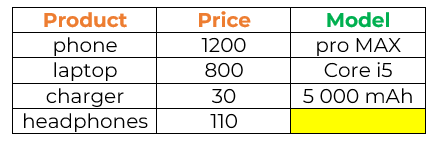
В которой у продукта «headphones» нет модели, так как в таблице «Model» данных о модели наушников нет. Будет просто пустое поле. И модель с ID «5» не попадет в результирующую таблицу RIGHT JOIN в Google BigQuery SQL (внешнее объединениe) – объединение таблицы которая стоит справа от джоина. Для примера возьмем те же таблицы price & model
Результатом будет таблица с отсутствующей ценой и названием продукта:
SELECT p.product, p.price, m.model FROM price AS p
RIGHT JOIN model AS m ON p.id = m.idSELECT p.product, p.price, m.model FROM price AS p
RIGHT JOIN model AS m ON p.id = m.id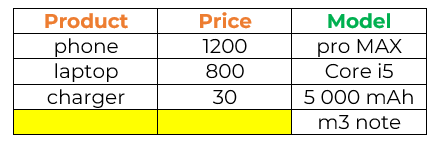
Правое и левое объединение можно легко переделать друг в друга, нужно просто изменить место таблицы слева от джоина или справа. На практике правое объединение используют редко, так как все можно сделать в левом - изменив расположение таблиц. FULL JOIN в Google BigQuery SQL (внешнее объединениe) – полное объединение, в него включаются строки из обеих таблиц даже те, у которых нет соответствующих строк в других таблицах.
SELECT p.product, p.price, m.model FROM price AS p
FULL JOIN model AS m ON p.id = m.id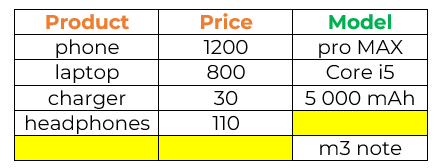
VIEW в Google BigQuery SQL Представление (VIEW) – это объект (виртуальная таблица) базы данных, которая хранит в себе запрос SELECT. При обращении к данному объекту будет возвращен результирующий набор данных (результат выполнения запроса). В представлении всегда находятся свежие данные. В Google BigQuery мы можем создать view и без запроса, то есть сохранить запрос в качестве view
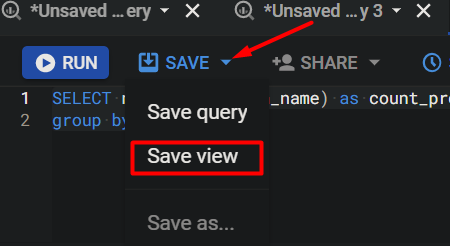
Синтаксис: CREATE VIEW название виртуальной таблицы AS SELECT столбцы FROM путь (имя таблицы) Для обновления представления: CREATE OR REPLACE VIEW название виртуальной таблицы AS SELECT столбцы FROM путь (имя таблицы) Для удаления представления: DROP VIEW название виртуальной таблицы; Для
примера создадим три таблицы: 1 – id, имя менеджера 2 – id, имя проекта, имя заказчика 3 – id менеджера и id проекта и имени заказчика
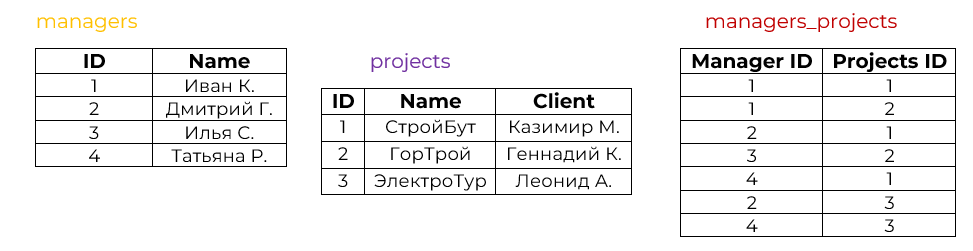
Хотим узнать какой менеджер отвечает за какой проект и сколько их у него. Создадим представление:
Как это выглядит в BigQuery SQL
CREATE VIEW all_managers_projects AS
SELECT m.name, p.name AS projects_name
FROM managers AS m JOIN managers_projects AS mp
ON m.id = mpmanager_id JOIN projects AS p
ON p.id = mp.project_id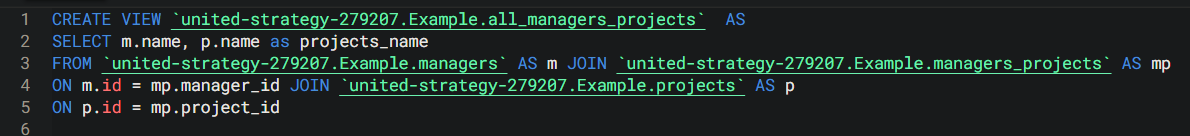
Результат работы запроса:
SELECT * from `united-strategy-279207.Example.all_managers_projects`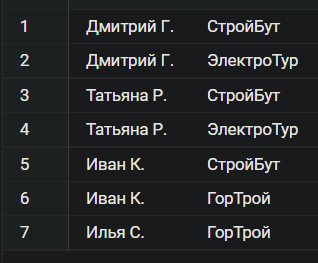
Теперь мы можем без усложнений и кучи кода обращаться к этой таблице. Например, какое количество проектов ведет каждый менеджер, цифра:
SELECT name, count(projects_name) as count_projects from `united-strategy-279207.Example.all_managers_projects`
group by name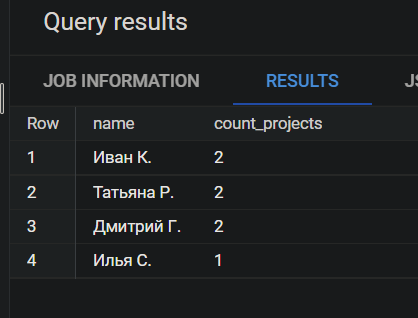
Пример простого запроса: WITH table_1 (название подзапроса) AS ( SELECT внутренний подзапрос …) SELECT нужные поля из table_1 FROM table_1 (обращение к внутреннему запросу)
Пример сложного более сложного запроса: WITH table_1 (название подзапроса) AS ( SELECT внутренний подзапрос …), table_2(название подзапроса) AS ( SELECT внутренний подзапрос …) и так далее SELECT * FROM table_1, table_2 WHERE table_1.id = table_2.id (обращение к внутреннему запросу) Пример возьмем из задачи, которую мы делали в VIEW
WITH в Google BigQuery SQL Common Table Expression (CTE) — результаты запроса, которые можно использовать множество раз в других запросах. То есть, запросом мы достаем данные, и они помещаются в пространство памяти, аналогично временному представлению, которое физически не сохраняется в виде объектов. Далее мы работаем с получившейся конструкцией как с таблицей, используя такие конструкции как select, update, insert и delete. Для этого мы используем конструкцию WITH Способы использования: - для улучшения читаемости запроса при использовании сложных запросов (намного уменьшается размер кода); - когда нужно много раз обращаться к одним и тем же таблицам/выборкам из таблиц; - для создания представлений/виртуальных таблиц (VIEW) - для написания рекурсивных запросов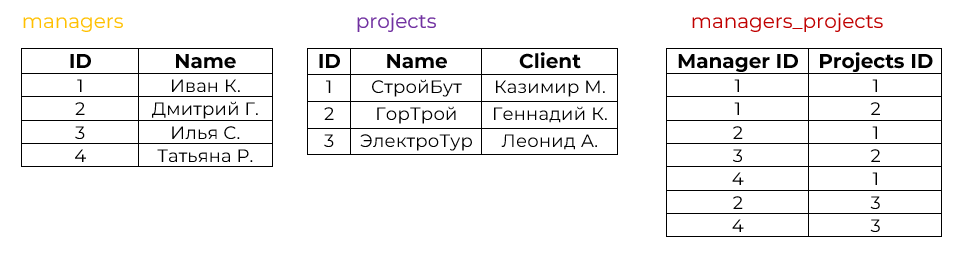
Хотим узнать какой менеджер отвечает за какой проект и сколько их у него. Но теперь мы не будем создавать представление, а создадим временную таблицу, к которой обратимся и произведем вычисления:
Результат, тот же что и в предыдущем примере с VIEW
WITH  all_managers_projects  AS (
SELECT m.name, p.name as projects_name
FROM `united-strategy-279207.Example.managers` AS m JOIN `united-strategy-279207.Example.managers_projects` AS mp
ON m.id = mp.manager_id JOIN `united-strategy-279207.Example.projects` AS p
ON p.id = mp.project_id
)
SELECT name, count(projects_name) as count_projects from all_managers_projects
group by name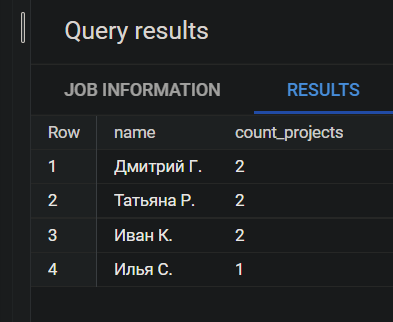
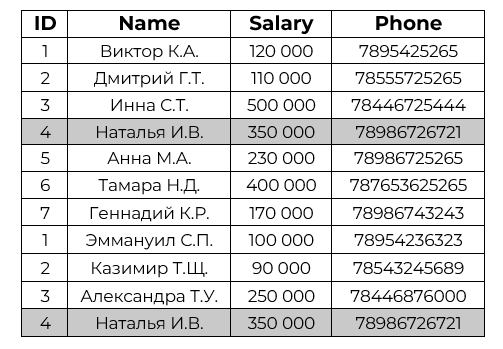
UNION & UNION ALL в Google BigQuery SQL Объединение данных UNION – это оператор SQL для объединения результирующего набора данных нескольких запросов, и данный оператор выводит только уникальные строки в запросах. UNION ALL – это оператор SQL для объединения результирующего набора данных нескольких запросов, но он выведет все строки, дубли в том числе. Необходимые условия для использования union и union all - Набор полей должен быть одинаковый во всех запросах, т.е. количество полей в каждом запросе, который будет объединяться должно быть одинаковое - Типы данных полей также должны совпадать в каждом запросе - В случае сортировки оператор order by можно указать только после последнего запроса. Например, у нас есть две базы данных (таблицы) в которых записаны менеджеры, их зарплата, и телефон.
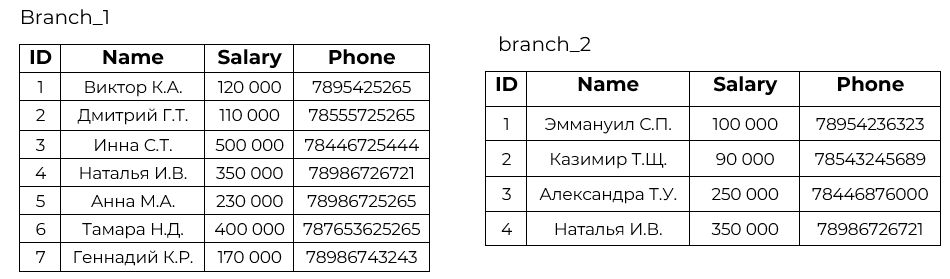
Пишем запрос: SELECT id, name, salary, phone FROM branch_1 UNION SELECT id, name, salary, phone FROM branch_2 Результатом запроса будет таблица, в которой будут все записи, но запись «Наталья И.В.» будет в одном экземпляре.
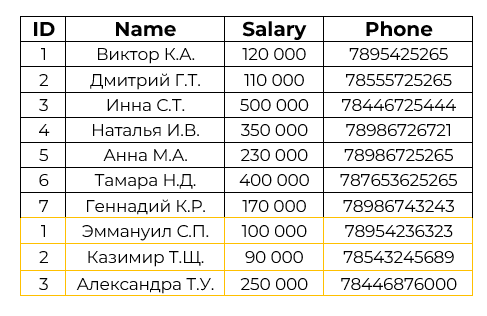
SELECT id, name, salary, phone FROM branch_1 UNION ALL SELECT id, name, salary, phone FROM branch_2 Результатом будет объединение таблиц без удаления дублей: